اگر تا به حال خواستهاید صدای خواننده را از یک آهنگ جدا کنید تا نسخه کارائوکه بسازید، تمرین آواز کنید یا ریمیکس بزنید، احتمالاً به سرویسهای آنلاین جداسازی صدا مراجعه کردهاید. مشکل این سرویسها معمولاً آپلود فایل به سرورهای خارجی، محدودیت حجم و هزینه اشتراک است. Vocal Splitter Local دقیقاً برای حل این مشکلات طراحی شده است.
این افزونه کروم، جداسازی وکال (صدای خواننده) را کاملاً داخل مرورگر و روی دستگاه خودتان انجام میدهد. هیچ فایلی آپلود نمیشود و پس از دانلود اولیه مدل، حتی میتوانید آفلاین کار کنید. در این مقاله آموزشی، با این ابزار، نحوه نصب و استفاده از آن آشنا میشویم.
معرفی پروژه Vocal Splitter Local
Vocal Splitter Local (یا VocalSplitter) یک افزونه متنباز برای مرورگر کروم است که با مدل هوش مصنوعی HTDemucs صدای خواننده را از موسیقی پسزمینه جدا میکند. تمام پردازش با ONNX Runtime Web و پشتیبانی از WebGPU (و در صورت نیاز WASM) داخل خود مرورگر انجام میشود.
خروجی برنامه دو فایل WAV است:
نامآهنگ_vocals.wav→ فقط صدای خواننده (آکاپلا)نامآهنگ_instrumental.wav→ موسیقی بدون صدا (نسخه کارائوکه)
پروژه توسط سجاد کاظمی توسعه داده شده، تحت لایسنس MIT منتشر شده و هسته پردازشی آن بر پایه پروژه demucs-web است. مدل حدود ۱۷۲ مگابایتی در اولین اجرا از Hugging Face دانلود و در IndexedDB مرورگر کش میشود.
ویژگیهای کلیدی
- جداسازی کاملاً محلی: هیچ فایلی به سرور ارسال نمیشود
- بدون نیاز به API یا اشتراک: رایگان و بدون محدودیت پولی
- مدل HTDemucs: یکی از مدلهای شناختهشده در جداسازی منابع موسیقی
- اجرا داخل مرورگر: با WebGPU برای سرعت بالاتر و بازگشت به WASM در صورت نیاز
- کش مدل: پس از دانلود اولیه، اجراهای بعدی آفلاین انجام میشود
- خروجی دوگانه: وکال و اینسترومنتال بهصورت جداگانه
- پشتیبانی از فرمتهای رایج: MP3، WAV، M4A، OGG، FLAC
- حریم خصوصی بالا: فقط فایل انتخابشده توسط کاربر خوانده میشود و به history یا کوکیها دسترسی ندارد
- نصب ساده بهصورت افزونه کروم: بدون نیاز به نرمافزار دسکتاپ سنگین
پیشنیازها
- مرورگر Google Chrome (یا مرورگرهای مبتنی بر Chromium که از افزونهها پشتیبانی میکنند)
- اتصال اینترنت فقط برای اولین اجرا (دانلود مدل حدود ۱۷۲ مگابایت)
- سختافزار مناسب: هرچه CPU/GPU و RAM قویتر باشد، پردازش سریعتر انجام میشود
- Node.js (فقط در صورتی که بخواهید از سورس بیلد بگیرید)
خروجی پیشفرض WAV است. برای تبدیل به MP3 میتوانید از FFmpeg یا Audacity استفاده کنید.
نحوه نصب و راهاندازی
دو روش اصلی برای نصب وجود دارد:
روش ۱: نصب از فایل آماده (پیشنهادی و سریعتر)
- به صفحه مخزن گیتهاب پروژه بروید و بخش Releases را باز کنید.
- فایل
vocal-splitter-local-dist.zipرا دانلود کنید. - فایل زیپ را Extract کنید تا پوشه
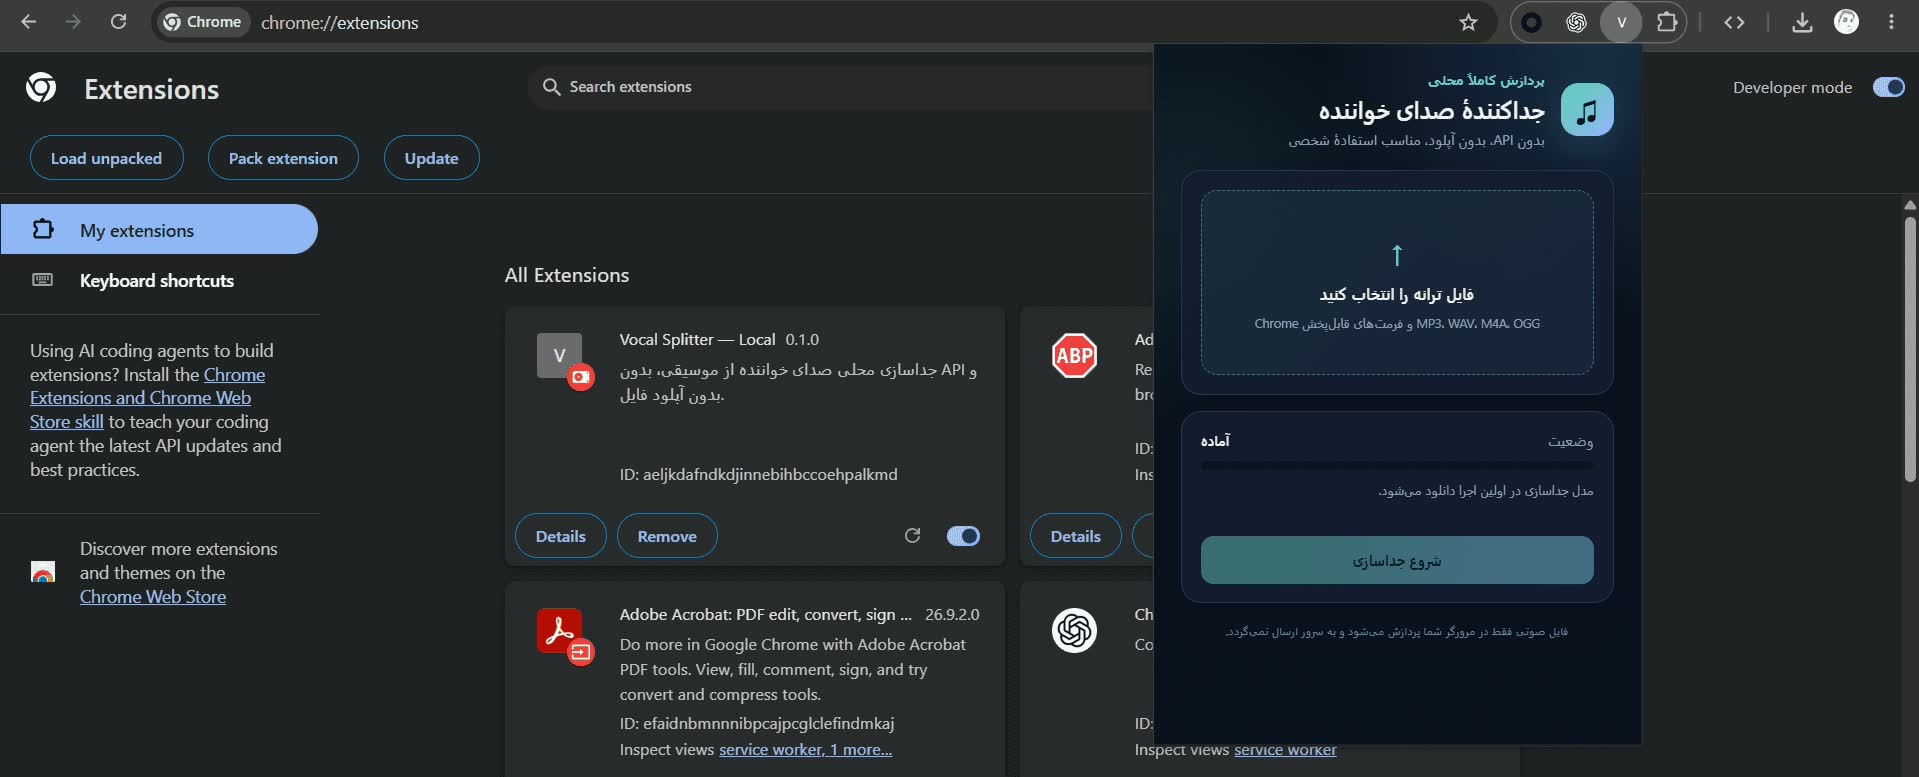
distبهدست آید. - در کروم آدرس زیر را باز کنید:
chrome://extensions
- گزینه Developer mode (حالت توسعهدهنده) را در بالا سمت راست فعال کنید.
- روی دکمه Load unpacked کلیک کنید و پوشه
distرا انتخاب کنید. - افزونه را با آیکون پین (Pin) به نوار ابزار کروم اضافه کنید.
روش ۲: ساخت از سورس
اگر میخواهید خودتان پروژه را بیلد کنید:
git clone https://github.com/Sajadapp/Vocal-Splitter-Local.git
cd Vocal-Splitter-Local
npm install
npm run build
سپس پوشه dist ایجادشده را مانند روش قبل با Load unpacked نصب کنید.
نحوه استفاده
استفاده از افزونه بسیار ساده است:
- روی آیکون Vocal Splitter در نوار ابزار کروم کلیک کنید تا پاپآپ باز شود.
- فایل آهنگ را بکشید و داخل پاپآپ رها کنید، یا از دکمه انتخاب فایل استفاده کنید.
- دکمه شروع جداسازی را بزنید.
- تا پایان پردازش، پاپآپ را باز نگه دارید (بستن آن باعث توقف کار میشود).
- پس از نمایش پیام «تمام شد»، دو فایل خروجی را دانلود کنید.
نکته مهم در اجرای اول:
مدل حدود ۱۷۲ مگابایتی از Hugging Face دانلود و در IndexedDB ذخیره میشود. این مرحله فقط یکبار انجام میشود و بعد از آن میتوانید آفلاین کار کنید.
تبدیل خروجی WAV به MP3 (اختیاری):
ffmpeg -i input_vocals.wav -codec:a libmp3lame -qscale:a 2 output_vocals.mp3
همین دستور را برای فایل instrumental هم میتوانید اجرا کنید.
نکات مهم
- پاپآپ را نبندید: پردازش در پاپآپ انجام میشود. بستن آن کار را قطع میکند.
- زمان پردازش: روی فایلهای طولانی و سیستمهای ضعیف ممکن است چند دقیقه طول بکشد. این موضوع طبیعی است.
- کیفیت جداسازی: روی آهنگهای استودیویی معمولاً نتیجه خوب است. در ضبطهای زنده، همخوانیهای گروهی، افکتهای سنگین یا سازهایی که صدای شبیه انسان دارند، ممکن است نقصهایی وجود داشته باشد.
- فرمت فایل: اگر فایلی خطا داد، ابتدا آن را در خود کروم پخش کنید. در صورت مشکل، با Audacity به WAV تبدیل کنید.
- حریم خصوصی: فقط فایل انتخابشده خوانده میشود. مجوز شبکه صرفاً برای دانلود مدل عمومی است.
- فضای ذخیرهسازی: مدل در IndexedDB مرورگر ذخیره میشود؛ فضای کافی روی دیسک داشته باشید.
نتیجهگیری
Vocal Splitter Local یک راهحل ساده، رایگان و حریمخصوصیمحور برای جداسازی صدای خواننده از موسیقی است. با اجرای مدل HTDemucs کاملاً داخل مرورگر، نیاز به آپلود فایل یا پرداخت اشتراک را حذف میکند و برای ساخت کارائوکه، تمرین آواز، ریمیکس و پروژههای صوتی شخصی بسیار کاربردی است.
اگر به دنبال ابزاری سبک و بدون دردسر برای جداسازی وکال هستید و نمیخواهید فایلهایتان را به سرویسهای ابری بسپارید، این افزونه گزینه مناسبی است. نصب آن فقط چند دقیقه زمان میبرد و پس از دانلود اولیه مدل، میتوانید بهصورت آفلاین از آن استفاده کنید.
بیشتر بخوانید:
VoiceStudio جایگزین متنباز و لوکال ElevenLabs
بهترین مدلهای TTS فارسی | راهنمای تبدیل متن به گفتار فارسی
ترجمه سریع زیرنویس فیلم و سریال با هوش مصنوعی